N
뉴스
더보기
제휴문의 @spostar
제휴문의 @spostar
 글쓰기
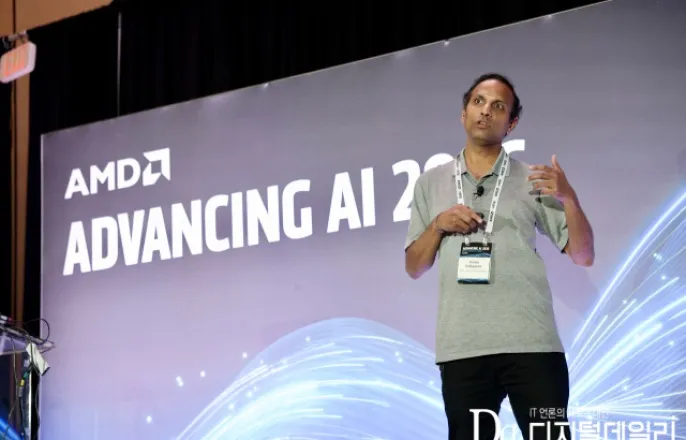
[IT뉴스]AMD가 제안한 3대 맞춤형 네트워킹…"AI, 데이터 이동 속도만큼 확장" [AAI 2026]
[인더스트리AI]GPU당2.4Tbps스케일아웃대역폭구현…AI작업완료시간13%단축[샌프란시스코(미국)=디지털데일리김문기기자]거대언어모델(LLM)과에이전틱AI의급부상으로10만개이상의GPU가연동되는대규모AI데이터센터에서,데이터이동병목을해결하는네트워킹아키텍처가시스템전체의가동효율을결정짓는핵심열쇠로부상했다.AMD가72개GPU수직통합랙스케일인프라'AMD헬리오스(Helios)'의연산효율을극대화하기위한프론트엔드,스케일업,스케일아웃3대맞춤형네트워킹솔루션과차세대펜산도DPU및AI-NIC의기술세부명세를전격공개했다.AMD는22일(현지시각)미국샌프란시스코모스콘웨스트에서열린연례플래그십컨퍼런스'어드벤싱AI(AdvancingAI)2026'딥다이브세션을통해차세대네트워킹플랫폼로드맵을발표했다.◆AI는데이터이동속도만큼확장…단하나의느린링크도용납못해크리슈나도다파네니(KrishnaDoddapaneni)AMD네트워킹기술솔루션그룹부사장은AI인프라확장에있어네트워킹이가지는절대적위상을강조하며포문을열었다.도다파네니부사장은"컴퓨팅성능과플롭(Flops)수치도중요하지만,AI클러스터의최상위성능과효율을얻기위해서는시스템내부와외부간데이터를극도로빠르게이동시켜야한다"며"10만개의GPU가참여하는대규모학습에서단하나의느린링크가전체성능을저하시킬수있고,분산추론환경에서는KV캐시접근지연을줄여야하므로결국AI는데이터이동속도만큼확장한다"고강조했다.이어"단하나의네트워킹구조로모든요구사항을충족할수는없다"며"AMD는데이터센터스토리지와사용자요청을처리하는'프론트엔드',랙내부72개GPU를단일메모리공간으로묶는'스케일업',랙간초거대클러스터를연동하는'스케일아웃'등3가지레이어별맞춤형네트워크로이과제를해결했다"고설명했다.◆3세대펜산도'살리나'DPU…KV캐시오프로드로에이전틱AI가속프론트엔드네트워크를담당하는핵심솔루션은3세대펜산도DPU인'살리나(Salina,400G)'다.글로벌하이퍼스케일러환경에6년이상대규모로공급되어검증을마친펜산도아키텍처기반으로,전작대비2배의성능향상을이뤄냈다.도다파네니부사장은살리나DPU의최대강점으로P4언어기반의하드웨어프로그래밍가능성을꼽았다.그는"AI기술이분기마다급변하는상황에서매번새로운ASIC을개발할수는없다"며"펜산도DPU는P4프로그램수정만으로데이터패스기능을신속히업데이트할수있으며,서버가동을중단하지않고도라이브소프트웨어업데이트를수행할수있다"고설명했다.특히최근급부상한에이전틱AI워크로드에서DPU의역할은더결정적이라고강조했다.사용자와AI간긴문맥을주고받는과정에서GPU메모리가부족해지면CPU나SSD로데이터를넘겨야하는데,살리나DPU가'NVMeKV캐시인터페이스'를라인레이트(Line-rate)속도로오프로드처리한다.도다파네니부사장은"DPU가KV캐시데이터이동을오프로드함으로써GPU메모리재연산에드는비용과시간을절약하고,더높은밀도로AI에이전트를구동할수있다"고덧붙였다.이외에도가상화네트워크,암호화,스테이트풀방화벽등보안기능을CPU간섭없이내재화했다.◆초당260TB'UALoE'스케일업패브릭…오픈소스'SONiC'및'AFM'으로제로터치관리단일랙내72개MI455XGPU를31TB의단일메모리공유공간으로묶어주는스케일업패브릭에는초당260TB대역폭의'UALoE(UltraAcceleratorLinkoverEthernet)'기술이적용됐다.복잡한다층구조대신단일홉L2스위치네트워크를구현해데이터이동지연시간을최저수준으로동결했다.이스케일업패브릭의제어는오픈소스네트워킹OS인'SONiC'과AMD가자체개발한'AFM(AMDFabricManager)'소프트웨어가담당한다.도다파네니부사장은"AFM소프트웨어는6개의스위치트레이상에분산배치되어실행되므로,단일스위치에장애가발생하거나RMA교체를위해제거되더라도고가용성(HA)을상시유지한다"며"운영자는랙을전원에연결하기만하면제로터치(Zero-touch)로72개GPU패브릭이자동구성되고,단일통합화면에서랙전체의자원현황과상태를실시간모니터링할수있다"고소개했다.더불어랙내부를가상파티션으로쪼개는'vPod'기술을통합제어해,멀티테넌트보안격리와물리적고장격리를소프트웨어차원에서구현한다.◆2세대펜산도'볼케이노'800GAI-NIC…오픈AI·바이트댄스협력프로토콜탑재랙과랙사이를연결해초거대AI클러스터를형성하는스케일아웃영역에는3nm공정기반의2세대펜산도AI-NIC'볼케이노(Vulcano,800G)'가출격한다.헬리오스랙내부에는GPU당최대3개의볼케이노AI-NIC가탑재되어GPU당2.4Tbps의압도적스케일아웃대역폭을제공한다.도다파네니부사장은"볼케이노AI-NIC를적용하면경쟁사네트워크아키텍처대비AI작업완료시간을13%단축할수있을뿐만아니라,필요스위치수량과케이블을대폭줄여네트워크구축비용을최대33%절감할수있다"고단언했다.특히볼케이노는글로벌빅테크들과손잡고개발한차세대지능형전송프로토콜을탑재했다.오픈AI와공동개발한'MRC(Multi-pathRDMAController)'프로토콜,바이트댄스와협력한'VERoCE'프로토콜등을P4프로그래밍으로전면지원한다.이를통해데이터전송시단일경로대신128~256개의미세경로로데이터를잘게쪼개어분산송출하는'지능형패킷스프레이'및경로인지형혼잡제어를수행한다.특정링크에병목이발생하더라도수마이크로초(µs)내에정상경로를찾아우회하므로대규모AI학습시지연시간왜곡현상을방지한다.도다파네니부사장은"하드웨어부터스위치OS,최상위랙관리소프트웨어까지UEC(UltraEthernetConsortium)및UA링크등개방형표준에기반해오픈생태계를구축했다"며"AMD의3단통합네트워킹플랫폼은하이퍼스케일러들이어떠한인프라환경에서도최상위가성비와회복탄력성으로AI공장을구축할수있도록만드는핵심토대가될것"이라고강조했다.Copyright©디지털데일리.Allrightsreserved.무단전재및재배포금지.
26-07-24 04:07
0
110
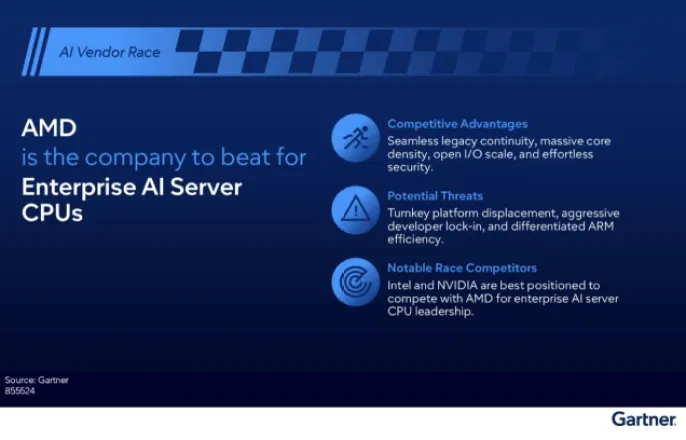
[IT뉴스][AAI 2026] 가트너 "기업용 AI 서버 CPU 시장, AMD가 '넘어서야 할 1위 선두주자'"
에이전틱AI오케스트레이션·I/O대역폭·서버통합경제학서독보적[샌프란시스코(미국)=디지털데일리김문기기자]글로벌시장조사기관가트너가엔터프라이즈AI서버CPU시장에서AMD를경쟁사들이넘어서야할가장강력한선두주자로평가했다.인공지능(AI)기술의중심축이단순추론에서연속적인오케스트레이션을요구하는'에이전틱AI(AgenticAI)'로이동함에따라,AMD에픽(EPYC)프로세서의높은코어밀도와높은I/O대역폭이데이터센터의핵심제어장치로부상했다는설명이다.가트너는최근발간한'AI벤더레이스:기업용AI서버CPU시장의주도자AMD(AIVendorRace:AMDIstheCompanytoBeatforEnterpriseAIServerCPUs)'보고서를통해AMD의기술적우위와시장경쟁구도를상세히조명했다.◆가트너"에이전틱AI가CPU-GPU균형재편…AMD'투린'이시장기준설정"워렌펭(WarrenPeng)과가우라브구프타(GauravGupta)가트너애널리스트는에이전틱AI의급부상이데이터센터내CPU의역할을근본적으로재편하고있다고지적했다.가트너는"기업용AI가지속적인오케스트레이션을요구하는동적에이전틱시스템으로전환되면서CPU성능이전체클러스터의제어성능을결정짓는핵심요인이되고있다"며"AMD의5세대에픽'투린(Turin)'플랫폼은높은병렬처리능력과지속적인I/O대역폭을제공해GPU가유휴상태에빠지지않고최적의가동효율을유지하도록보장한다"고설명했다.가트너분석에따르면,5세대에픽투린프로세서는소켓당최대192개의코어와12개의DDR5메모리채널,2소켓서버기준최대160개의PCIeGen5I/O레인을제공한다.이러한높은확장성은멀티벤더가속기및고성능인터커넥트패브릭을자유롭게연동할수있는유연성을구현한다.데이터센터의한정된전력및냉각한계상황에서도AMD의고밀도코어기반서버통합경제학이작동하고있다.가트너는"AMD의높은코어밀도는기업들이기존레거시인프라를대거통합할수있게해주며,이를통해절감된전력과공간을고밀도액체냉각AIGPU클러스터배치를위한전력헤드룸으로전환할수있게돕는다"고분석했다.보안면에서도성숙한'SEV-SNP(SecureEncryptedVirtualizationwithSecureNestedPaging)'하드웨어기밀컴퓨팅기술을바탕으로기업의독자적인AI모델과데이터를보호한다고덧붙였다.◆인텔·엔비디아·ARM의도전…'폐쇄형수직통합및락인전략'경계해야가트너는AMD가선두자리를유지하기위해경쟁사들의폐쇄형수직통합및생태계락인(Lock-in)전략을지속적으로경계해야한다고조언했다.가트너는"인텔과엔비디아,그리고ARM기반CPU벤더들은CPU,가속기,네트워킹을독자적인초고속인터커넥트로묶는폐쇄형풀스택수직통합카드로AMD의모듈형개방성에맞서고있다"며"운영단순성과신속한배포를원하는기업들을타깃으로한사전검증된턴키파드제공이AMD의입지를위협할수있다"고밝혔다.또한"ARM기반CPU솔루션들이특정CPU집약적오케스트레이션및데이터이동워크로드에서뛰어난전력대성능비를무기로랙당처리량을높이는대안으로부상하고있다"면서도"그러나광범위한범용기업환경에서는소프트웨어생태계호환성과기존인프라관리의연속성면에서x86기반의AMD가여전히경쟁사들이넘어서야할강력한기준점"이라고강조했다.Copyright©디지털데일리.Allrightsreserved.무단전재및재배포금지.
26-07-24 03:37
0
106
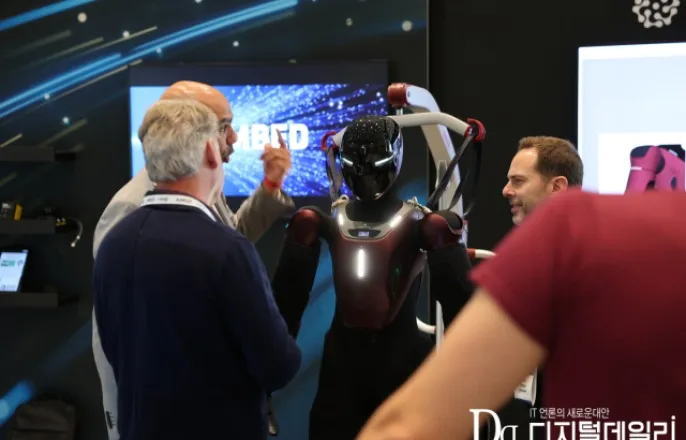
[IT뉴스][AAI 2026] "제어 없는 AI 로봇은 안 움직인다"…AMD '크리아 AI'가 바꾼 산업 현장
[르포]전시장에4족보행로봇·휴머노이드·자율이동로봇수십대집결[샌프란시스코(미국)=디지털데일리김문기기자]모니터화면속에서텍스트와이미지로만대화하던인공지능(AI)이현실세계로쏟아져나왔다.상단라이다센서와비전카메라를번뜩이며전시장카펫위를사뿐사뿐거니는4족보행로봇부터,사람의손재주를그대로닮아나무블록을정교하게고쳐쥐는전신휴머노이드,반도체공장무인화를이끄는자율이동로봇(AMR)까지면면이다양하다.22일(현지시간)미국샌프란시스코모스콘웨스트에서열린AMD연례컨퍼런스'어드벤싱AI(AdvancingAI)2026'전시장은단순한서버장비전시회를넘어'피지컬AI(PhysicalAI)'가지배하는로봇전초기지로변모했다.오는2035년2000억달러(약276조원)규모로팽창할피지컬AI시장을겨냥해AMD가제시한'제어+AI'풀스택솔루션이전시장곳곳에서가시적인실물로구현됐다.전시장에들어서자마자관람객들의발길을사로잡은것은에이브넷(Avnet)과로봇전문기업웨스턴로봇이협력해선보인4족보행로봇이었다.로봇상단에장착된회전형라이다센서와전면비전카메라가전시장내부의인파와장애물을실시간으로감지하며유연하게걸음을옮겼다.둔탁한기계음대신기민한관절모터음만내며정교하게수색및점검동작을수행한다.휴머노이드로봇시연대에도많은인파가몰렸다.제너레이티브바이오닉스(GenerativeBionics)부스에서는검은색매끄러운헬멧과가슴중앙의유선형LED라이트가미래감성을풍기는전신휴머노이드로봇이설치돼있다.바로옆테스트베드에서는관절모터와배터리패크가드러난하체보행로봇구조체가대형모니터속3D디지털트윈시뮬레이션화면과실시간으로유기적으로동기화되며중심을잡는시연이펼쳐졌다.또다른휴머노이드개발사파운드레이션파트너십존에서는관람객이로봇의손앞에나무블록을놓자,로봇이다관절손가락을섬세하게움직여블록을집어올리고정교하게위치를맞추는장관이연출됐다.현장에서시연을지켜보던한관람객은"과거에는로봇관절하나를제어하는데수많은외부브리지칩과별도가속기가필요해핸드셰이크지연시간이발생했지만,단일유니파이드메모리상에서제어연산과비전AI추론이125마이크로초(µs)수준으로처리되는것이눈으로확인된다"며감탄을표했다.공장자동화와제조현장을바꿀정밀협동로봇및가공로봇부스들도일제히고도화된지능을과시했다.글로벌로봇제조사ABB로보틱스는고속·고하중작업을수행하는'포와(PoWa)코봇패밀리'를전시했다.알록달록한부품들을고속으로집어올려상자에담아내는과정에서한치의오차도허용하지않았다.티칭펜던트에는공간좌표와제어상태가실시간으로출력됐다.유니버설로봇(UniversalRobots)역시관람객이직접터치스크린으로경로를입력하면다관절로봇손이정밀하게반응하는시연을선보였다.자바(Xaba)부스에서는투명보호글라스관내부에들어선황색공작용로봇팔이분주히움직였다.상단듀얼모니터에는AI가로봇의물리적응력과공구경로를실시간으로추적·보정하는리눅스터미널가동화면과터미널로그가쉴새없이교차했다.레보메이션(REVOMATION)의스카라(SCARA)로봇도투명케이스안에서초소형부품을빛의속도로스캔하고정교하게이식해냈다.대만반도체물류자동화전문기업캐스텍인터내셔널(CASTECInternational)부스에서는실제반도체웨이퍼클린룸에투입되는협동자율이동로봇'아이오퍼레이터(i-Operator)'가관람객들을맞이했다.하단이동체상단에다관절로봇팔이결합된이로봇은노트북화면에비전카메라가인지한웨이퍼스토커와장애물영역을초록색경계상자로바운딩하며수송경로를자율생성했다.이모든움직임의바탕에는AMD가이번행사에서공개한'라이젠AI임베디드X100'프로세서와'크리아AISOM(KriaAISystemonModule)'이라는'두뇌'가자리잡고있었다.칩렛구조기반의16코어'Zen5'CPU와40개컴퓨트유닛의'RDNA3.5'GPU,50TOPS성능의'XDNA2'NPU가단일메모리공간을공유함으로써복사과정없는실시간제어를구현해낸것이다.전시장한편에높게솟은'AMD헬리오스(AMDHELIOS)'대형구조물앞에서는커스텀기념품을즉석인쇄해주는이벤트와함께수많은글로벌파트너사관계자들이모여로보틱스파트너네트워크구축과인프라도입상담을이어갔다.Copyright©디지털데일리.Allrightsreserved.무단전재및재배포금지.
26-07-24 03:37
0
107
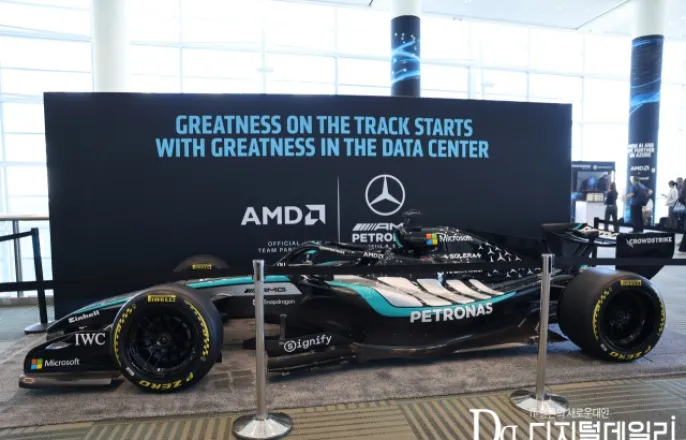
[IT뉴스][AAI 2026] F1 머신 몰아보고 콕핏 체험까지…'실시간 AI 시뮬레이션'에 탄성
[르포]메르세데스-AMGF1머신실물등판…관람객시선집중[샌프란시스코(미국)=디지털데일리김문기기자]메르세데스-AMG페트로나스F1레이싱머신이관람객들을맞이한다."트랙위위대함은데이터센터의위대함으로부터시작된다"는문구를시작으로,시속350km로달리는극한의머신제어와자율주행모빌리티의핵심두뇌가결국초고성능컴퓨팅(HPC)과데이터센터기술에서출발한다는메시지를던진다.22일(현지시간)미국샌프란시스코모스콘웨스트에서열린AMD의플래그십컨퍼런스'어드벤싱AI(AdvancingAI)2026'전시장한편은F1레이싱시뮬레이터부터차세대차량용인포테인먼트(IVI),디지털트윈콕핏에이르기까지'초고속모빌리티및실시간AI시뮬레이션'기술을직접체험하려는관람객들로온종일장사진을이뤘다.가장긴체험대기줄이늘어선곳은고급전문시뮬레이터장비기업파나텍(Fanatec)과커세어(Corsair)가협력해구축한'F1AI레이싱시뮬레이터'구역이다.관람객들은파나텍의포디엄버킷시트와BMWGT3및포뮬러V3레이싱휠을고쳐쥐고,파노라마처럼펼쳐진트리플커브드디스플레이속가상서킷을경험했다.상단4번째모니터로구성된'라이브피트월(LivePitwall)'스크린에는운전자의주행보행,코너링궤적,가속페달반응속도가실시간AI텔레메트리분석데이터로가파른그래프를그렸다.운전이끝나면인공지능이운전자의서킷주행영상을분석해하이라이트리일영상으로즉석생성해제공했다.3D가상서킷과실시간AI분석을동시에지탱하는하드웨어스펙역시현장에서투명하게공개됐다.시뮬레이터구동용PC내부에는최신'AMD라이젠79800X3D'프로세서와'AMD라데온RX9070XT'그래픽카드가탑재됐다.커세어도미네이터타이타늄RGBDDR5메모리가결합되어초당수백프레임의끊김없는고화질렌더링을시폭시켰다.이어발길을옮긴모빌리티존에서는AMD와3D인프라엔진선도기업언리얼엔진(UnrealEngine)이공동개발한'차세대디지털트윈차량콕핏'시연대가위치했다.차세대전기차시트를연상시키는청록색가죽시트와운전석전면을가로지르는긴필라투필라파노라믹디스플레이에관람객이앉아운전대를잡자,전면대형화면에언리얼엔진으로3D렌더링된가상차량과가상주차장환경이펼쳐졌다.상단모니터에는차량주위에달린4개의비전카메라가실시간으로수집하는360도서라운드비전영상이지연시간없이정밀하게연동됐다.차안에서실시간으로차량외부의사물과도로상황을공간인지하고,중앙인포테인먼트화면으로차량상태데이터를유기적으로전달하는구조다.현장에서콕핏을직접체험한한IT엔지니어는"실제자동차에탑재되는엣지실리콘단에서언리얼엔진수준의복잡한3D그래픽렌더링과4채널카메라비전AI인지를동시처리하는성능에놀랐다"며"데이터센터에서학습된물리AI모델이차량내부콕핏환경으로자연스럽게이식된완성도높은사례"라고평했다.Copyright©디지털데일리.Allrightsreserved.무단전재및재배포금지.
26-07-24 03:37
0
103

[IT뉴스]AMD, 차세대 AI 칩 핵심축에 HBM4 배치… “매년 메모리 대역폭 강화”
차세대AI가속기탑재된HBM용량대폭확대“HBM4대부분은삼성전자가공급”매년HBM대역폭늘려AI성능높인다앤드류디크만(AndrewDieckmann)AMD데이터센터GPU사업부담당부사장이22일(현지시각)미국샌프란시스코에서열린'AMD어드밴싱AI2026'에서차세대AI가속기헬리오스솔루션을설명하고있다./샌프란시스코=황민규기자AMD가차세대인공지능(AI)반도체성능을끌어올리는핵심축으로고대역폭메모리(HBM)를전면에내세웠다.매년신제품을낼때마다연산능력뿐아니라메모리용량과속도를함께키우는것을차세대AI가속기제품전략의핵심에두겠다는것이다.AMD는22일(현지시각)미국캘리포니아주샌프란시스코모스콘웨스트에서열린연례행사‘AMD어드밴싱AI2026’에서신형AI가속기‘인스팅트(Instinct)MI455X’를공개했다.이날앤드류디크만AMD데이터센터GPU(그래픽처리장치)사업부담당부사장은신제품로드맵을소개하며“매세대연산능력뿐아니라메모리부문에서도새로운발전을담고있다”고밝혔다.◇HBM412단적층으로대역폭2.9배확대MI455X부터메모리강화흐름이뚜렷해졌다.최신메모리인HBM4(6세대HBM)를12단으로쌓아얹어칩1개당저장용량432기가바이트(GB),데이터처리속도인대역폭은초당23.3테라바이트(TB)를구현했다.이는전작MI355X가HBM3E(5세대HBM)를8단으로쌓아용량288GB를구현했던것과비교하면용량은1.5배,속도는2.9배늘어난수치다.디크만부사장은이같은속도향상이단순히클럭을높인결과가아니라고설명했다.그는“메모리를쌓는층수를8단에서12단으로늘리고,메모리와칩을잇는통로의폭도기존1024비트에서2048비트로두배넓힌것이핵심”이라고설명했다.연산능력이전작대비최대4배좋아진것과별개로,메모리쪽에서만독자적으로큰폭의개선이이뤄진셈이다.MI455X는이런메모리성능을제대로활용하기위해서버의두뇌역할을하는중앙처리장치(CPU)와의연결방식도함께손봤다.짝을이루는CPU는6세대AMD서버용프로세서(EPYC)로,GPU와CPU사이를초당256GB속도로오가는전용통로로직접연결해CPU가GPU메모리에지연없이접근할수있도록했다.그는“이같은설계를통해데이터를주고받는과정에서생기는병목을줄이고,메모리강화효과가시스템전체성능으로그대로이어지도록했다”고설명했다.여러개의AI칩을하나의랙(서버캐비닛)으로묶은시스템‘헬리오스(Helios)’에서도메모리확대효과는이어진다.최대72개의MI455X를하나로묶은헬리오스랙전체기준으로HBM4총용량이31테라바이트(TB),메모리대역폭은초당1.7페타바이트(PB)에달한다.개별칩단위의메모리강화가랙단위로확장되는구조인셈이다.◇“HBM4대부분삼성전자가공급…HBM4E도협력중”22일(현지시각)미국샌프란시스코에서열린'AMDAI어드밴싱2026'행사장에공개된차세대AI시스템'헬리오스'서버랙./샌프란시스코=황민규기자현장에서만난AMD고위관계자는“MI455X에들어가는HBM4물량의대부분은삼성전자가공급할예정”이라고설명했다.삼성전자는메모리를12단으로쌓은36GB급HBM4제품을준비중이며,데이터를주고받는속도도이전세대인HBM3E보다크게끌어올린것으로전해졌다.이관계자는AMD와삼성전자가그동안메모리용량과대역폭을함께키우는방향으로협력해온만큼,차세대제품인HBM4E(7세대HBM)단계에서도양사협력이한층공고해질것이라고설명했다.HBM4E는16단적층과60GB대용량,초당십수테라바이트급대역폭을목표로개발이진행중인것으로알려졌다.한편AMD와삼성전자는올해3월삼성전자평택사업장에서HBM4를포함한차세대메모리분야협력을확대하는내용의양해각서(MOU)를체결한바있다.당시공개된삼성전자의HBM4제품은12단으로쌓아올린형태로,10나노급공정(1c)을적용해핀하나당최대초당13기가비트(Gbps)의속도를내며,스택하나당대역폭은최대초당3.3테라바이트(TB)에이르는것으로알려졌다.-Copyrightⓒ조선비즈&Chosun.com-Copyright©조선비즈.무단전재및재배포금지.
26-07-24 03:37
0
98
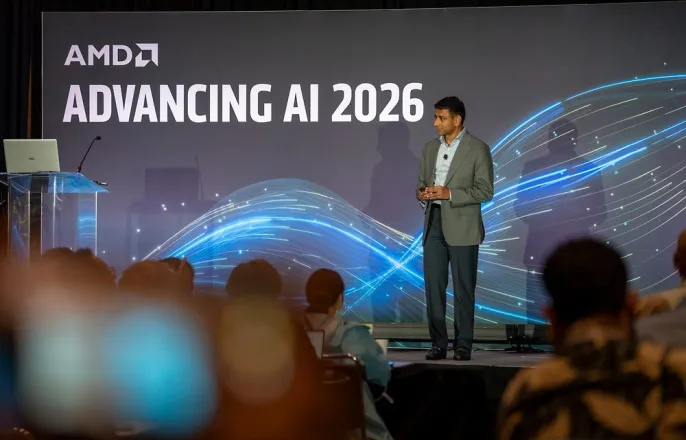
[IT뉴스]AMD, 2나노 서버용 CPU 에픽 ‘베니스’ 양산… “엔비디아 베라보다 처리량 2.2배↑”
AI에이전트시대,CPU오케스트레이션역할부각“에이전틱워크플로우상당수가CPU연산과직결”에픽베니스,4분기부터고객사순차출하22일(현지시각)미국샌프란시스코모스콘웨스트에서열린AMD어드밴싱AI행사에서라비쿠푸스와미AMD컴퓨트및엔터프라이즈AI솔루션부문수석부사장이'에픽베니스'를설명하고있다./샌프란시스코=황민규기자AMD가2나노공정기반의6세대서버용중앙처리장치(CPU)에픽‘베니스(EPYCVenice)’의공식양산을선언했다.AMD는22일(현지시각)미국샌프란시스코모스콘웨스트에서열린‘AMD어드밴싱AI(AdvancingAI)2026’세션에서에픽베니스세부라인업을공개하며,동일조건에서엔비디아‘베라’대비연산처리량이2.2배,인텔6세대제온대비토큰처리속도가1.8배빠르다는벤치마크결과를함께내놨다.◇에이전틱AI시대,CPU가핵심변수로부상최근AI와의상호작용방식이크게바뀌고있다.과거에는사용자가질문을던지면AI가답을내놓는단발성구조가일반적이었지만,최근에는AI가스스로여러단계를판단하고필요한도구를실행하며작업을이어가는‘에이전틱AI’가확산하고있다.그동안그래픽처리장치(GPU)에비해상대적으로주목받지못했던CPU가다시데이터센터의핵심변수로떠오르고있는것이다.수많은AI에이전트를조율하고,이들이작업을실행하는샌드박스환경을실시간으로통제하는역할이CPU성능에달려있기때문이다.라비쿠푸스와미AMD컴퓨트및엔터프라이즈AI솔루션부문수석부사장은이날세션에서“과거챗봇시대에는사용자입력에답을주는단선적구조였지만,현재에이전틱AI시대는복수의에이전트와도구가유기적으로작동하는구조”라며“AMD가에이전틱워크플로우를분석한결과세부작업의상당부분이CPU연산성능과직결되는것을확인했다”고말했다.이번에공식양산을발표한베니스는차세대‘Zen6’및‘Zen6c’아키텍처를기반으로하며고객사의활용목적에따라4가지라인업으로나눠순차적으로출시된다.가장먼저나오는플래그십모델‘에픽9006SP7’은대형데이터센터사업자를겨냥한최고성능제품으로,Zen6c아키텍처적용시최대256코어(512스레드)까지지원한다.특히서버CPU업계최초로PCI익스프레스(PCIe)Gen6규격과1.6TB/s의초고속메모리대역폭을갖췄다.SP7은현재양산에돌입한상태이며올4분기부터출하된다.비용효율성에초점을맞춘‘SP8’은2027년상반기,HPC·데이터전처리에특화한‘베니스-X’와저전력AI서버용‘베라노’는2027년하반기에출하될전망이다.AMD는지난2017년1세대에픽출시당시0.2%에불과했던서버CPU매출점유율을2026년1분기기준46%까지끌어올린상태다.◇엔비디아·인텔대비앞선성능지표제시22일(현지시각)미국샌프란시스코모스콘웨스트에서열린AMD어드밴싱AI2026에서공식양산이발표된2나노공정기반서버용CPU'에픽베니스'./황민규기자AMD는이날최근엔비디아가공개한차세대CPU‘베라(Vera)’,인텔제온플랫폼과직접비교한벤치마크결과를공개했다.동일한구동조건에서베니스(256코어/600W)는엔비디아베라(88코어/450W)대비연산처리량이2.2배앞섰고,코어하나당성능으로비교해도20%우위를보였다고설명했다.랙단위로보면베니스기반랙은랙하나에최대4만9152개의코어를담을수있어,엔비디아베라랙(2만2528코어)보다코어집적도가2.2배높았다.GPU를호스트하는노드환경에서는인텔6세대제온과비교해토큰처리속도가1.8배빨랐다.기존서버를베니스로교체했을때의효과도구체적인수치로제시됐다.AMD는5년전도입된인텔제온골드기반구형서버1000대가처리하던연산량을베니스(EPYC9996)서버단82대로대체할수있다고강조했다.이경우데이터센터전력소비량을최대77%줄이고,5년간의총소유비용(TCO)도40%절감할수있다는계산이다.쿠푸스와미수석부사장은“6세대에픽‘베니스’는세분화된AI데이터센터의모든영역을완벽히지원하도록설계된최고의CPU포트폴리오”라며“압도적인처리속도와초고속메모리대역폭을통해차세대AI인프라시장의주도권을더욱공고히할것”이라고말했다.-Copyrightⓒ조선비즈&Chosun.com-Copyright©조선비즈.무단전재및재배포금지.
26-07-24 03:37
0
67
[IT뉴스]“엔비디아 대비 30% 비용 절감”… AMD, ‘토큰 비용’ 중심으로 AI 인프라 재설계
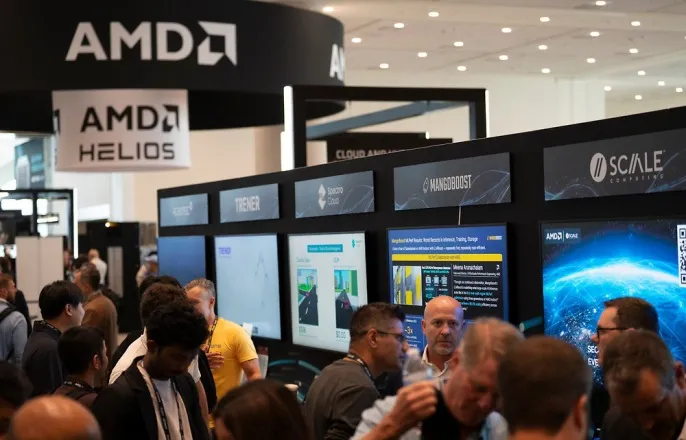
‘AI어드밴싱2026′서헬리오스공개엔비디아대비속도↑,비용30%절감美주요빅테크에대규모공급예정22일(현지시각)미국샌프란시스코에서열린'AMDAI어드밴싱2026'행사장내데모존./샌프란시스코=황민규기자챗봇에질문하나만던지고끝나던시절은지났다.이제인공지능(AI)은스스로계획을세우고,여러도구를불러쓰고,중간결과를다시검토하는식으로하나의요청에도수십,수백번씩답을주고받는‘에이전틱(agentic)AI’로진화하고있다.질문하나에토큰하나면끝나던과거와달리지금은작업하나를처리하는데도훨씬더많은토큰이소모된다는얘기다.이가운데AMD는반도체칩하나의성능을자랑하는대신,다른접근법을택했다.칩과서버,이들을잇는네트워크장비까지통째로묶은AI인프라전체를‘토큰1개를얼마나싸게만들어내느냐’를기준점으로시스템전체를재설계했다.아무리칩하나의연산속도가빨라도,그칩을감싸는서버와네트워크가병목이되면전체비용은줄지않는다는문제의식에서출발한접근이다.◇“AI서비스,‘속도’보다‘토큰1개값’이관건”AMD는22일(현지시각)미국샌프란시스코모스콘웨스트에서열린연례행사‘AMD어드밴싱AI2026’에서신형AI가속기‘인스팅트(Instinct)MI455X’와이를랙단위로묶은시스템‘헬리오스(Helios)’를공개했다.이날AMD는헬리오스의최대강점으로칩·서버·네트워크를처음부터하나의세트로함께설계했다는점,이를통해랙하나를통째로돌렸을때의실제운영비용이얼마나줄었는지를핵심메시지로내세웠다.토큰은AI모델이문장을만들어낼때사용하는최소단위다.챗GPT나클로드같은AI서비스에질문을하면AI는답변을토큰단위로하나씩만들어내는데,이토큰을만드는데드는전기세와하드웨어비용등이곧AI기업의운영원가다.특히에이전틱AI처럼AI가스스로여러단계를거쳐작업을처리하는방식이늘어날수록,하나의요청을처리하는데소비되는토큰수자체가기하급수적으로늘어난다.AMD는이날AI산업에서벌어지고있는구조적변화도함께짚었다.앤드류디크만AMD데이터센터GPU사업부담당부사장은“AI반도체수요는2024년만해도모델을학습시키는‘훈련’작업이전체의60%를차지했지만,2026년에는실제서비스에답을내놓는‘추론’작업이60%로역전됐다”며“모델을한번잘만들어두면그이후에는매일수많은사용자에게,그것도점점더복잡해지는방식으로답변을내놓는게AI반도체의주된업무가됐다”고설명했다.이런흐름에서는칩하나가얼마나빨리계산하느냐보다,칩과서버,네트워크를하나로묶은인프라전체가토큰하나하나를만드는데돈을얼마나쓰느냐가더중요해진다.AMD가이번발표에서개별부품성능보다‘랙전체의경제성’을앞세운것도이때문이다.◇칩넘어랙전체를하나의시스템으로재설계22일(현지시각)미국샌프란시스코에서열린'AMD어드밴싱AI2026'행사에서공개된차세대AI시스템'헬리오스'./샌프란시스코=황민규기자이같은방식의접근을구체화한결과물이AMD의차세대AI솔루션헬리오스다.AMD는개별반도체를개선하는데그치지않고서버용CPU(중앙처리장치)와GPU,이들을잇는네트워크장비까지처음부터하나의세트로함께설계했다.부품하나하나의성능을극대화하는대신전체시스템이톱니바퀴처럼맞물려돌아가도록만들어낭비되는비용을줄이겠다는접근이다.AMD는비용뿐만아니라성능측면에서도경쟁사인엔비디아의차세대랙시스템‘베라루빈NVL72’대비비교우위를내세웠다.AMD에따르면실제AI모델(KimiK2Thinking)을돌려본자체테스트에서헬리오스는응답속도조건에따라엔비디아제품보다처리속도가10~15%더빨랐다.이를비용으로환산하면같은돈을들여도최대30%더많은토큰을뽑아낼수있다는게AMD의계산이다.AMD측은헬리오스를설계하면서같은비용으로더많은연산을처리하는데초점을맞췄다고설명했다.개별부품성능을높이는방식이아니라랙전체의비용대비산출량을끌어올리는쪽으로설계방향을잡았다.AI기업입장에서같은예산으로도AI서비스를통해더많은결과물을뽑아낼수있도록지원해AI생태계에서의영향력을확대하겠다는전략이다.AMD관계자는“개별칩이아닌인프라전체를경제성중심으로재설계한것은결국AI기업들이반도체를고를때최종적으로따지는게‘연산능력’자체가아니라‘얼마나싸게서비스를운영할수있는가’라는판단이작용했다”라며“오픈AI,메타,마이크로소프트,오라클,앤트로픽등대형AI기업들이이미헬리오스도입을확정한것도이런생산성논리가작용한것”이라고설명했다.-Copyrightⓒ조선비즈&Chosun.com-Copyright©조선비즈.무단전재및재배포금지.
26-07-24 03:37
0
111

[IT뉴스]리사 수 "현존 세계 최고" 들고나온 엔비디아 대항마는? [AMD 어드밴싱 AI]
신형랙'헬리오스'AMD행사서공개GPU·CPU·네트워킹등묶은장치로승부"성능과확장성동시에갖춘플랫폼필요"앤트로픽·오픈AI·메타에도공급파트너십쿠다대항할ROCm효율성도대폭개선리사수AMDCEO가23일(현지시간)샌프란시스코에서열린AMD의'어드밴싱AI2026'기조연설중헬리오스랙에들어가는6세대CPU베니스,신형GPUMI455X등반도체를설명하고있다./사진=김인엽특파원"헬리오스는현존하는세계최고의인공지능(AI)랙입니다."23일(현지시간)샌프란시스코에서열린AMD의'어드밴싱AI2026'행사기조연설에나선리사수AMD최고경영자(CEO)는이같이말하며신형랙헬리오스를공개했다.랙은AI데이터센터에들어가는그래픽처리장치(GPU),중앙처리장치(CPU),네트워킹장치등을하나로묶은장치다.수CEO는헬리오스에들어가는반도체들을직접들어보이며"업계에서가장높은성능을자랑하는AI가속기"라고자신했다.CPUGPU네트워킹까지'통'으로승부이번AMD발표의핵심은반도체를하나씩파는대신랙단위로사업모델을확장했다는점이다.헬리오스는AMD최신GPU인인스팅트MI455X72개와6세대베니스CPU18개,자체네트워킹기술'펜산도(Pensando)'를하나의랙에담았다.랙1개당최대2.9엑사플롭스(FP4기준)의연산성능과31테라바이트(TB)의6세대고대역폭메모리(HBM4)메모리를갖췄다는게회사측설명이다.AMD의헬리오스랙./사진=AMD바미시보파나AMDAI수석부사장은"프론티어AI인프라가빠르게진화하면서고객들은성능과확장성을동시에갖춘플랫폼을필요로하고있다"며"헬리오스는컴퓨팅과네트워킹,소프트웨어를하나로묶은제품"이라고말했다.AMD는헬리오스가경쟁사엔비디아의'베라루빈'NVL72랙대비같은비용으로최대30%더많은AI작업을처리할수있다고주장했다.다만이는AMD자체성능연구소(PerformanceLabs)의자체벤치마크결과로,실제상용환경에서의성능은시스템구성에따라달라질수있다.앤트로픽·오픈AI·메타계약으로엔비디아위협이날가장눈길을끈것은세계적인AI기업들과AMD의파트너십발표였다.수CEO는앤트로픽의공동창업자인톰브라운최고컴퓨팅책임자(CCO)와직접무대로불러앤트로픽에최대2기가와트(GW)규모의헬리오스랙을제공한다고밝혔다.원자력발전소2기를돌려야하는초대형AI인프라를공급하기로한것이다.양사는여기에더해앤트로픽의AI모델클로드를활용해AMD의반도체설계및소프트웨어개발을최적화하는다년간엔지니어링협력도발표했다.AMD는사내엔지니어링·제품개발조직전반에클로드를도입하기로했다.리사수AMDCEO와산토시자나르단메타글로벌인프라총괄이23일(현지시간)샌프란시스코에서열린어드밴싱AI2026서밋에서대담하고있다./사진=김인엽특파원오픈AI도GPT시리즈를AMDGPU에서더욱잘작동하도록최적화작업을진행중이다.올해말부터헬리오스를도입해내년부터본격적으로확대할계획이다,메타는6세대에픽CPU를자사실험실에서검증중이며헬리오스랙테스트에도착수했다고전했다.AMD는AI반도체스타트업세레브라스와도협력한다.양사는하나의작업에서헬리오스와세레브라스의'웨이퍼스케일엔진(WSE)'을분리해운용하는합작솔루션을공개했다.큰작업은헬리오스가처리하고즉시처리해야하는작업은셀레브라스칩이맡는방식이다.셀레브라스의WSE는웨이퍼전체를AI연산에사용하는반도체로,지연속도가적어코딩등업무에적합하다는평가를받는다.헬리오스가방대한AI계산을처리하는동안세레브라스의특수반도체는사용자에게답변을빠르게생성하는역할을맡는다.AMD는이조합을이용하면전력1와트당AI처리량이기존보다최대5배늘어난다고설명했다.이는엔비디아가작년말스타트업'그록(Groq)'핵심인재들을영입하며그록LPU(언어처리장치)를공개한것과같은'저지연특화전략'이라는분석이나온다.소프트웨어효율도전작대비3.3배높여6세대CPU인베니스는AI에이전트시대에맞게설계됐다.전세대와달리AI에이전트업무를3가지역할로구분해설계한게특징이다.에이전트를직접실행하는'SP7'(최대256코어),전력효율을우선한범용서버용'SP8'(8~128코어),고성능컴퓨팅(HPC)용'SP7X',GPU피딩에특화한저전력'LP'(옛코드명'베라노')등4개라인업으로나눴다.AI를직접실행하는모델,전력효율을중시하는서버,슈퍼컴퓨터용,GPU를지원하는전용모델등으로CPU를세분화한것이다.소프트웨어측면에서는새브랜드'ROCmai'를내놨다.ROCm은AMDGPU가AI를효율적으로실행하도록돕는소프트웨어다.엔비디아의쿠다(CUDA)와같은역할을한다.ROCmai는AI연산에맞게ROCm을개선한버젼이다.이는설치·배포·관리를통합한명령줄도구'ROCmCLI',클로드·커서·코덱스등AI코딩도구에AMD전용지식을심는'AMD스킬',추론워크로드최적화를자동화하는에이전트'하이퍼룸(Hyperloom)'등3가지로구성됐다.AMD는자체테스트결과기존ROCm7대비추론성능은평균3.3배,학습성능은2.4배향상됐다고밝혔다.ROCmai는오는8월정식출시된다.AMD는이날로보틱스전용반도체·플랫폼인'크리아(Kria)AI솔루션'을공개하며피지컬AI시장공략의지를밝혔다.라이젠AI임베디드X100시리즈프로세서를탑재한시스템온모듈(SOM)과,CPU·GPU·신경망처리장치(NPU)·FPGA를하나의플랫폼에통합한로보틱스개발플랫폼이핵심이다.살릴라제AMD임베디드담당수석부사장은"로봇의몸체를넘어두뇌까지아우르는첫개방형통합플랫폼"이라고소개했다.크리아AISOM은올4분기협력사(ODM)를통해출시될예정이다.실리콘밸리=김인엽특파원[email protected]©한국경제.무단전재및재배포금지.
26-07-24 03:37
0
67
[IT뉴스][AAI 2026] "2026년 추론 비중 60% 역전"…AMD, 앤트로픽·MS·오픈AI 잡았다
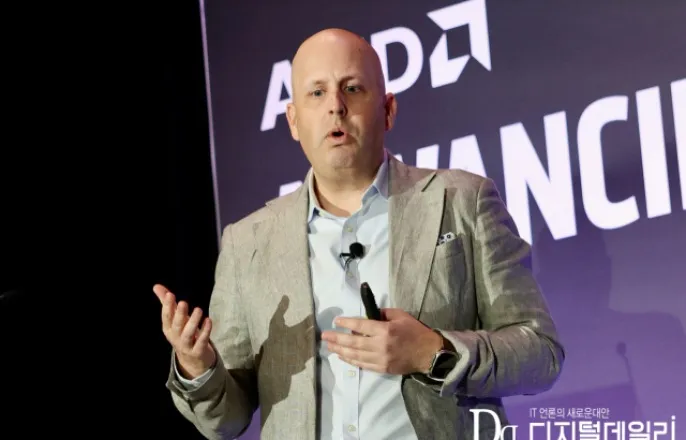
[인더스트리AI]앤드류디크만부사장"CPU·GPU균형잡힌인프라필수"오픈AI·메타·MS이어앤트로픽까지기가와트급헬리오스도입클로드모델활용해ROCm최적화가속AMD,앤트로픽에최대50억달러지분투자[샌프란시스코(미국)=디지털데일리김문기기자]고성능가속기의연산속도가아무리빨라도데이터를밀어주는관이좁거나전체시스템이어그러지면실전에서속도를내기어렵다.인공지능(AI)데이터센터시장의중심이모델학습에서실시간추론과에이전트제어로옮겨가면서,단품칩의스펙을넘어랙(Rack)단위의시스템효율과경제성으로향하고있다.AMD는22일(현지시각)미국샌프란시스코모스콘웨스트에서연례플래그십컨퍼런스인'어드벤싱AI(AdvancingAI)2026'에서앤드류디크만(AndrewDieckmann)AMD데이터센터GPU사업부담당부사장은AI워크로드의구조적변화를짚으며,차세대'인스팅트MI455X'가속기와'AMD헬리오스(Helios)'랙스케일솔루션의구체적인성능지표와시장성과를공개했다.또한이를기반으로AI인프라의새로운표준을겨냥한차세대2나노가속기와통합랙솔루션배포를공식선언했다.◆추론비중60%로역전…"에이전틱AI시대엔CPU와GPU의균형이핵심"앤드류디크만부사장은현재AI시장을움직이는가장큰동력으로'추론워크로드의폭발적인증가'를꼽았다.과거에는AI모델을학습시키는구매결정이주를이뤘으나,최근18개월사이AI시장의지형도가완전히뒤바뀌었다는설명이다.디크만부사장은"2024년전체데이터센터AI워크로드의60%를차지했던학습비중은2025년50대50으로균형을이뤘고,올해인2026년에는추론이60%를점유하며명실상부한대표워크로드가됐다"고강조했다.실제로지난2년간월간소비된AI토큰양은158배급증해최근35쿼드릴리온토큰에육박하고있다.여기에'에이전틱AI(AgenticAI)'가대중화되면서인프라요구조건은한차원더높아졌다.그는"에이전틱루프가구동될때는GPU의추론연산뿐만아니라,데이터를검색하고워크플로우를통제하는호스트CPU의오케스트레이션역할이동시에급증한다"며"이때문에GPU와CPU,네트워킹이처음부터긴밀하게맞물려설계된균형잡힌시스템이필수적"이라고설명했다.◆2나노공정·432GBHBM4탑재한'MI455X'…헬리오스랙양산돌입이러한시장요구에대응하기위해AMD는차세대'CDNA5'아키텍처기반의'인스팅트MI455X'가속기와이를수직통합한'AMD헬리오스'랙솔루션을공개했다.MI455X는TSMC2나노(nm)공정을적용해생산되며,3,200억개의트랜지스터를집적했다.특히단일가속기기준업계최대용량인432GB의고대역폭메모리(HBM4)를장착해전작대비메모리용량과대역폭을대폭끌어올렸다.디크만부사장은헬리오스랙에대해"현재현장에서실제로양산돼고객사인프라에안착하고있는시스템"이라며자신감을내비쳤다.헬리오스랙은6세대에픽'베니스(Venice)'CPU와72개의MI455XGPU,펜산도네트워킹및UALoE패브릭을하나의개방형랙표준으로묶어냈다.이를통해랙당FP4기준2.9엑사플롭스의연산성능과31TB의총HBM4메모리용량을제공하며,스케일업대역폭은260TB/s에달한다.◆엔비디아'베라루빈'정조준…달러당토큰생성량30%우위경쟁구도와관련해디크만부사장은엔비디아의차세대'베라루빈NVL72'솔루션과의정량적비교수치를공개했다.헬리오스랙은베라루빈NVL72대비AI연산성능에서15%,총HBM메모리용량과스케일아웃대역폭에서각각50%우위에있다는설명이다.이를바탕으로실무고객들이체감하는경제성지표인'달러당토큰생성량'측면에서최대30%더뛰어난가치를제공한다고덧붙였다.소프트웨어장벽에대한질문에대해서는과거와달라진시장분위기를전했다.디크만부사장은"과거에는고객들과미팅을할때쿠다(CUDA)관련우려가주를이뤘으나,현재주요대형고객들과의대화에서쿠다는거의언급조차되지않는비(非)이벤트가됐다"고잘라말했다.이어"개발자들이더높은추상화레벨의프레임워크와서빙도구를사용하고있으며,클로드나코덱스같은AI에이전트들이AMDROCm플랫폼으로의코드최적화를보조하고있어소프트웨어전환장벽이과거보다훨씬낮아졌다"고설명했다.실제로AMD는오픈AI,메타,마이크로소프트에이어최근앤트로픽과최대2기가와트(GW)규모의헬리오스도입파트너십을체결하는등글로벌하이퍼스케일러들의대규모실전배포를이어가고있다.한편AMD는이날발표에서2026년MI400시리즈에이어,2027년차세대HBM과구리·광학인터커넥트를적용할'MI500시리즈(CDNA6)',2028년'MI600시리즈'로이어지는연례로드맵을소개하기도했다.Copyright©디지털데일리.Allrightsreserved.무단전재및재배포금지.
26-07-24 03:37
0
110
[IT뉴스][단독]서울대·엔비디아, '피지컬AI 조인트 랩' 추진…아시아 권역 최초
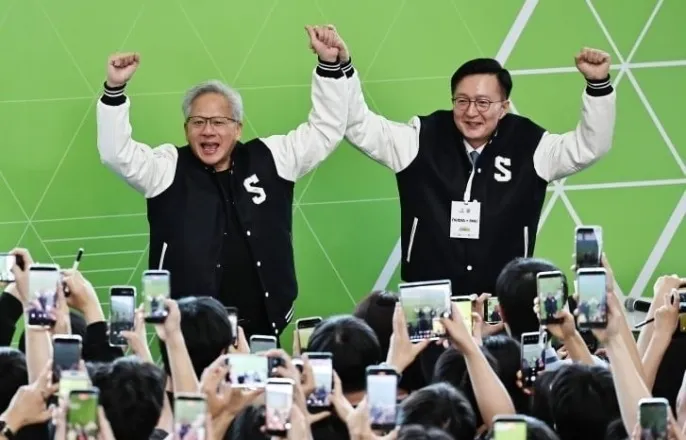
서울대AI연구원주관…공동연구·인적교류추진엔비디아GPU·로봇AI기술접목…연구거점구축젠슨황방문후본격협력…아시아첫조인트랩젠슨황엔비디아최고경영자(CEO,왼쪽)이지난6월서울대해동첨단공학관에서열린'빌드어클로(Build-a-Claw)'행사장에서유홍림서울대총장(오른쪽)과손을잡은모습.연합뉴스서울대와엔비디아가피지컬인공지능(AI)분야공동연구에나선다.로봇과제조,의료등다양한분야를아우르는서울대의연구역량과엔비디아의AI도구·컴퓨팅기술을결합해피지컬AI연구거점을구축한다는구상이다.지난달젠슨황엔비디아최고경영자(CEO)의서울대방문이후양측협력에도속도가붙고있다.24일대학가에따르면서울대와엔비디아는서울대관악캠퍼스에‘서울대-엔비디아피지컬AI조인트랩(가칭)’을설치하는방안을논의하고있다.서울대AI연구원이사업을주관하며공동연구개발과연구자,학생간인적교류등을추진할예정이다.연구주제와참여진등세부사항은조율중인것으로알려졌다.조인트랩은AI가로봇과기계등물리적장치를인식하고판단해직접움직이도록하는피지컬AI를중점적으로다룰전망이다.엔비디아의그래픽처리장치(GPU)를비롯해로봇학습소프트웨어와컴퓨팅인프라가연구에활용될전망이다.앞서엔비디아는서울대기계공학부에'젯슨오린나노슈퍼개발자키트'20대를무상제공한바있다.또기계공학부정규과목에자사의교육프로그램을적용하는방안을검토하고있다.엔비디아가서울대를협력대상으로택한배경에는의료등피지컬AI와연계되는여러학과를보유한종합대학이라는점이꼽힌다.로봇이실제환경에서작동하려면AI모델개발뿐아니라기계설계와소재,센서,제어,인간과의상호작용등다양한분야의연구가결합돼야한다.양측의협력논의는올해들어엔비디아핵심인사들이서울대를잇달아찾으면서구체화됐다.브라이언카탄자로엔비디아응용딥러닝연구부문부사장은지난4월서울대에서특별강연을했고같은달젠슨황의장녀인매디슨황엔비디아피지컬AI플랫폼제품·기술마케팅담당수석이사도AI연구원과로보틱스연구소를찾아서울대피지컬AI기술현황을둘러봤다.이어젠슨황CEO는지난6월8일서울대를방문해학생들과AI에이전트를제작하는행사에참여하고AI연구원과로보틱스연구현장을살폈다.엔비디아는해외대학에도공동연구거점을두고있다.2024년미국피츠버그에서카네기멜런대(CMU),피츠버그대와‘엔비디아AI기술커뮤니티’를출범시키고두개의공동연구센터를설립했다.CMU는로보틱스·자율시스템연구센터를,피츠버그대는보건의료분야의AI지능형시스템연구센터를각각주도한다.CMU공동연구센터에는엔비디아의기술전문가가배치돼대학연구진과협업한다.아시아권역에서AI분야조인트랩이설립되는것은이번이처음이다.아시아에서는홍콩이공대가2023년디자인대학내에‘홍콩이공대-엔비디아공동연구센터’를세워문화·예술·기술분야공동연구를진행하고있다.서울대도최근피지컬AI연구역량을강화하고있다.조규진기계공학부교수가이끄는서울대로보틱스연구소는최근과학기술정보통신부와교육부가추진하는국가연구소사업인‘NRL2.0’에선정되기도했다.엔비디아외에글로벌빅테크들이서울대와협력을이어가고있다.앞서서울대는오픈AI와전략적업무협약을맺고교육·연구전반에AI를접목하는‘AI네이티브캠퍼스’를구축했고,그일환으로학내구성원에게교육기관용생성형AI서비스인‘챗GPT에듀’를제공한바있다.최영총기자[email protected]©한국경제.무단전재및재배포금지.
26-07-24 03:07
0
113
[IT뉴스]“주말 맡겼더니 새 GPU 세팅 끝”…AI가 AI 반도체 개발[AMD 어드밴싱 2026]
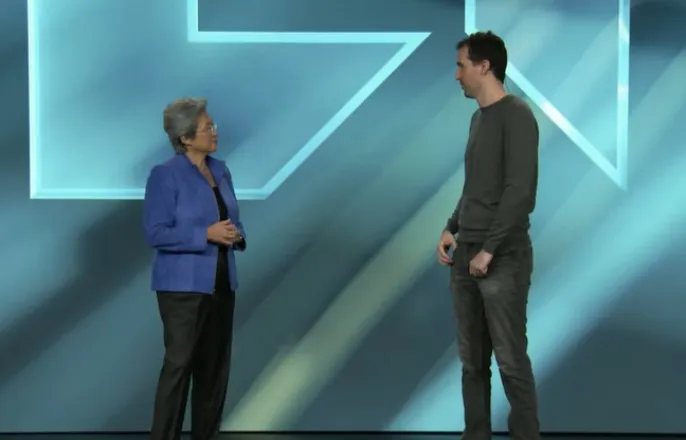
앤스로픽,클로드로HW이식자동화AMD는개발조직전반에클로드도입오픈AI도헬리오스서GPT급시험가동리사수AMDCEO(왼쪽)와톰브라운앤트로픽공동창업자가23일(현지시간)미국샌프란시스코에서열린AMD어드밴싱2026에서함께발표하고있다.[사진=AMD]“엔지니어한명이클로드를그기계에연결하고‘이머신을세팅해봐’라고시킨뒤주말내내그냥놔뒀다.월요일에돌아와보니우리최신모델의성능그래프가계속올라가있었다.”톰브라운앤스로픽공동창업자는23일(현지시간)샌프란시스코모스코니센터에서열린AMD‘어드밴싱AI2026’기조연설무대에올라자사인공지능(AI)모델클로드가AMD신형AI가속기의초기구동작업을사실상혼자끝냈다며이같이말했다.새로운하드웨어플랫폼을처음가동시키는작업은통상대규모엔지니어링조직이수개월간매달리는난제로꼽힌다.브라운창업자는“새하드웨어플랫폼을올리는건언제나거대한작업이라이번에도큰프로젝트가될것으로예상했다”며“그런데실제경험은엔지니어한명이시작해끝났다”고말했다.무대에함께선리사수AMD최고경영자(CEO)도“우리팀이앤스로픽엔지니어가MI355를만지고있다고보고하길래‘지원이필요하지않느냐’고물었더니‘도움이필요없다고한다’는답이돌아왔다”고덧붙였다.이날대담은AMD와앤스로픽이지난22일발표한대규모협력직후이뤄졌다.앤스로픽은AMD의랙단위시스템‘헬리오스’에인스팅트MI450시리즈그래픽처리장치(GPU)를최대2기가와트(GW)규모로배치한다.첫1GW가동은2027년상반기시작된다.AMD는앤스로픽에최대50억달러규모지분투자도약정했다.톰스하드웨어에따르면이번계약으로AMD는엔비디아,아마존트레이니엄,구글텐서처리장치(TPU)등에이어클로드를떠받치는여섯번째반도체공급원이된다.주목되는것은두회사가맺은다년엔지니어링협력의내용이다.앤스로픽은클로드를AMD의GPU워크로드최적화와소프트웨어개발에투입하고,AMD는자사엔지니어링·제품개발조직전반에클로드를도입하기로했다.브라운창업자는“클로드의주특기는소프트웨어엔지니어링이지만이제는설계나레이아웃처럼통상적인소프트웨어개발과다른작업도돕고있다”며“다음세대칩을더좋게만드는지점에서함께일할수있다”고말했다.이어서무대에오른사친카티오픈AI인프라총괄도같은진단을내놨다.그는“우리의핵심베팅중하나는재귀”라며“AI가자신이돌아갈시스템을재귀적으로개선하고,궁극적으로는AI가연구자체를수행하는것”이라고말했다.지금은전문엔지니어들이커널최적화와하드웨어별모델이식에막대한시간을쏟고있지만AI가그상당부분을자동화하는것이이미실제서비스환경에서입증되고있다는설명이다.카티총괄은“오픈AI가3개월전헬리오스랙을받아이미GPT급워크로드를구동하고있으며,대규모배치는올해말시작해2027년내내가속할것”이라고밝혔다.오픈AI는지난해AMD와최대6GW규모인프라도입계약을맺은바있다.AMD는이날헬리오스의성능수치도공개했다.자사측정기준으로MI455는이전세대대비최대34배높은처리량과18배많은달러당토큰처리량을기록했고,동일한랙전력에서경쟁제품보다평균10~15%높은성능과최대30%많은달러당토큰처리량을냈다.카티총괄은“이제업계전체가깨닫고있는것은이것이랙차원이아니라데이터센터전체가하나의시스템이라는문제”라며“인간의속도에발목잡히는대신AI가그일을직접하도록만들어가고있다”고말했다.[실리콘밸리원호섭특파원]Copyright©매일경제&mk.co.kr.무단전재,재배포및AI학습이용금지
26-07-24 02:27
0
124
[IT뉴스]리사수 “AI가속기 시장 1.4조달러”…1년만에 전망 3배 상향[AMD 어드밴싱]
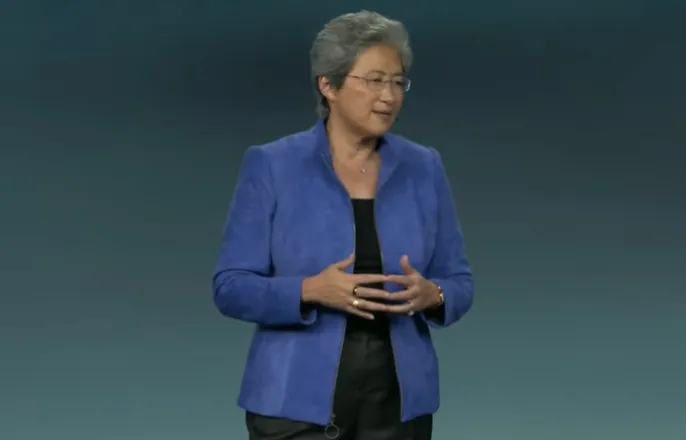
리사수“추론이학습넘어섰다”2030년AI가속기시장1조4000억달러AMD차세대AI랙‘헬리오스’양산앤스로픽과최대2GWGPU공급계약리사수AMDCEO가23일(현지시간)미국샌프란시스코에서열린AMD어드밴싱2026에서기조강연을하고있다.[사진=AMD유튜브캡처]“1년전이자리에서2028년AI가속기시장이5000억달러가될것이라고말했을때는굉장히큰숫자로느껴졌다.그런데지금보면그숫자는보수적이다.“리사수AMD회장겸최고경영자(CEO)는23일(현지시간)미국샌프란시스코모스콘센터에서열린‘어드밴싱AI2026’기조연설에서“2030년AI가속기시장이1조4000억달러규모에이를것”이라며“10년이끝날무렵이면AI가속기시장이지금의전체반도체시장규모에육박할수있다”고강조했다.전망치를올린근거로그는AI연산의무게중심이학습에서추론으로넘어갔다는점을들었다.수CEO는“2026년처음으로전세계가모델을학습시키는것보다실행하는데더많은AI컴퓨팅을쓰게됐다”며“올해전세계AI컴퓨팅용량의약60%가추론에쓰일것”으로내다봤다.매달소비되는토큰은3경5000조개로2년만에약160배늘었고첨단모델학습에들어가는연산량도최근4~5년간매년5배안팎으로증가했다는설명이다.추론수요를밀어올리는것은AI에이전트다.수CEO는“초기거대언어모델(LLM)은질문에답하는데그쳤지만에이전트는목표를주면문제를풀때까지계속일한다”며“에이전트에일을시키면수십단계에걸쳐추론하고도구를호출하고데이터에접근하는과정을반복한다”고말했다.이어“그연산을처리할GPU도많이필요하지만,모든단계를조율할CPU도대량으로필요하다”고강조했다.이때문에이날수CEO는서버CPU시장전망도함께상향했다.AMD는지난해까지서버CPU시장이연평균18~20%성장해600억달러규모가될것으로봤지만이날은현재250억달러수준인이시장이2030년2000억달러를넘어설것이라고수정했다.에이전틱AI확산속도가예상보다훨씬빨랐다는것이다.그는“모든고객과의대화에서이투자는이제시작이라는얘기가나온다”고전했다.AMD는지난분기서버시장에서매출점유율46%로자체최고치를기록했고,포춘100대기업중60%이상이에픽프로세서를쓰고있다.이날공개된핵심제품은랙단위AI시스템‘헬리오스’다.수CEO는“업계최고성능의AI랙”이라며“헬리오스가양산에들어갔다”고밝혔다.출하는3분기말시작해4분기부터본격화한다.AMD는경쟁제품과비교해연산성능은15%,HBM4용량과메모리대역폭은50%,스케일아웃대역폭은50%앞선다고주장했다.수CEO는경쟁사를실명으로거론하지않았지만엔비디아의랙시스템‘NVL72’를겨냥한수치로풀이된다.헬리오스에는인스팅트MI455XGPU와에픽‘베니스’CPU,펜산도네트워킹칩이함께들어간다.MI455X는트랜지스터3200억개를집적했으며TSMC2나노미터·3나노미터공정으로만든12개칩렛과432기가바이트메모리를3D적층패키징으로묶었다.랙한대에는CDNA5GPU컴퓨트유닛1만8000개이상,젠6CPU코어4600개이상,HBM431테라바이트가들어간다.수CEO는무대에서GPU와CPU,네트워킹칩을차례로들어보이며“에이전틱AI시대에는최고성능의GPU와CPU가함께움직여야하고,둘다만드는회사는우리뿐”이라고강조했다.AMD는전략의두번째축으로개방형생태계를내세웠다.헬리오스는랙내부연결에UA링크,외부연결에개방형울트라이더넷표준을쓴다.엔비디아가자체규격인NV링크로생태계를묶는것과대비된다.수CEO는“하드웨어표준과소프트웨어모두에서개방형생태계가AI의미래에필수적”이라며자체소프트웨어스택ROCm투자를강조했다.앞서22일AMD와앤스로픽은최대2기가와트규모의MI450시리즈GPU를헬리오스랙형태로배치하는파트너십을발표했다.첫1기가와트배치는2027년상반기시작된다.AMD는앤스로픽에최대50억달러를지분투자하기로했고,앤스로픽의클로드를AMD반도체설계와ROCm개발에활용하기로했다.발표당일AMD주가는8%넘게올랐다.수CEO는AMD의고성능·적응형컴퓨팅제품시장전체가연평균40%성장해2030년2조달러에근접할것으로전망했다.그는“그런시장을감당할수있는유일한방법은생태계가함께움직이는것”이라며“어느한회사도이문제를혼자풀수없다”고말했다.국내반도체업계도이번발표를주시하고있다.MI455X는GPU한개당HBM4432기가바이트를쓰는데,이는엔비디아차세대GPU베라루빈의288기가바이트보다150기가바이트가량많다.랙단위로는31테라바이트다.삼성전자가MI450시리즈용HBM4주력공급사로유력하다는관측이나오는가운데SK하이닉스도AMD물량확대를노리고있다.2기가와트배치가현실화하면양사HBM4수요가큰폭으로늘어날수있다.[실리콘밸리원호섭특파원]Copyright©매일경제&mk.co.kr.무단전재,재배포및AI학습이용금지
26-07-24 02:07
0
124
업체홍보/구인
더보기
놀이터홍보
더보기
지식/노하우
더보기
판매의뢰
더보기
-
[제작판매]html5웹미니게임제작 해시게임제작 카드포커게임제작 스포츠토토 카지노 슬롯 에볼루션 토지노 솔루션분양임대재작
-
[제작판매]html5웹미니게임제작 해시게임제작 카드포커게임제작 스포츠토토 카지노 슬롯 에볼루션 토지노 솔루션분양임대재작
-
[제작판매]html5웹미니게임제작 해시게임제작 카드포커게임제작 스포츠토토 카지노 슬롯 에볼루션 토지노 솔루션분양임대재작
-
[제작판매]html5웹미니게임제작 해시게임제작 카드포커게임제작 스포츠토토 카지노 슬롯 에볼루션 토지노 솔루션분양임대재작
-
[제작판매]html5웹미니게임제작 해시게임제작 카드포커게임제작 스포츠토토 카지노 슬롯 에볼루션 토지노 솔루션분양임대재작
포토
더보기


